
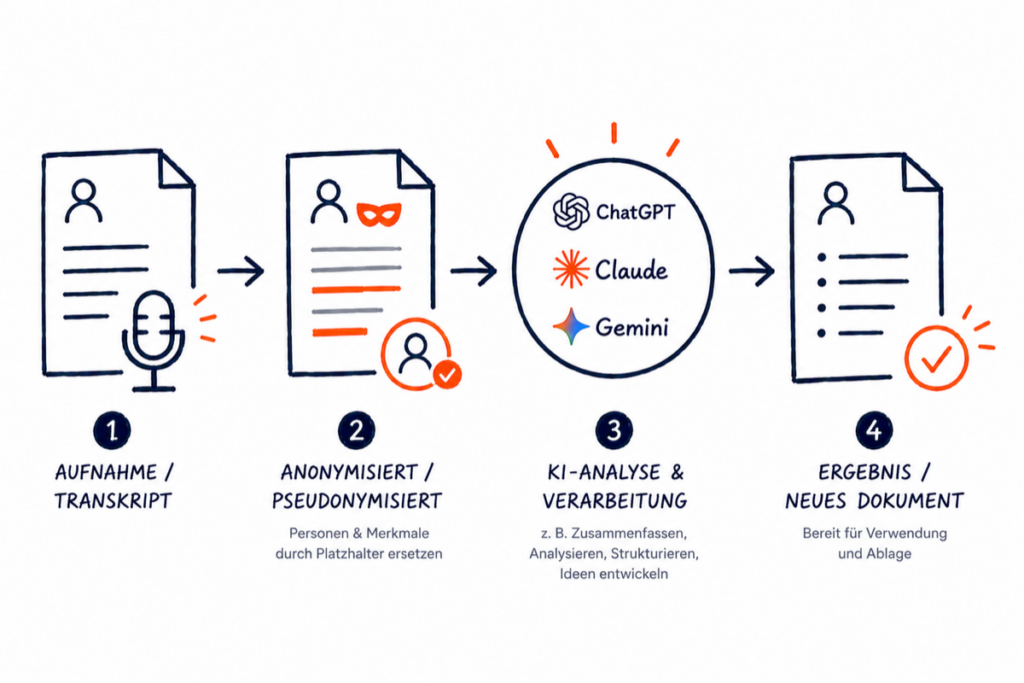
Bevor Du ein Transkript, einen Vertrag oder ein Protokoll in ChatGPT oder eine andere öffentlich zugängliche KI eingibst, solltest Du personenbezogene Angaben daraus entfernen. Das gilt besonders bei öffentlich zugänglichen KI-Diensten, für deren Nutzung Dir keine passende datenschutzrechtliche Grundlage zur Verfügung steht.
Die gute Nachricht: In den meisten Fällen musst Du dafür nicht alles anonymisieren. Oft reicht es schon, alle Angaben zu entfernen, an denen die KI eine bestimmte Person erkennen könnte. Ein sauber bereinigter Text ist oft der wirksamste Schutz für Deine Daten. Und er kostet nur wenige Minuten.
⏱ Durchblick in 30 Sekunden wenn Du wenig Zeit hast: der Kern des Artikels zum Aufklappen
Der Unterschied zwischen Pseudonymisieren und Anonymisieren klingt nach Wortklauberei, er entscheidet jedoch darüber, wie viel Arbeit du hast. Anonymisieren heißt: die Person ist endgültig raus, niemand kann sie je wieder zuordnen, auch Du nicht. Beim Pseudonymisieren ersetzt Du Namen und Merkmale durch Platzhalter, behältst aber selbst den Schlüssel, mit dem sich die Sache zurückführen ließe. Aus „die Klientin, Physiotherapeutin mit eigener Praxis in Goslar“ wird „eine Selbstständige im Gesundheitsbereich“. Das Dokument taugt weiter für die Aufgabe. Die Person ist für die KI aber nicht mehr greifbar.
Warum die Business-Version Dich nicht rettet
Viele denken, mit ChatGPT Team, ChatGPT Enterprise oder Microsoft 365 Copilot erledige sich das Thema von selbst. Sie hoffen, die Bezahl- oder Team-Version nehme ihnen das Bereinigen ab, weil dort ein Auftragsverarbeitungsvertrag greift, kurz AVV.
So einfach ist es leider nicht.Der regelt aber nur, wer für wen verarbeitet, er verschafft Dir keine Erlaubnis, die Du nicht ohnehin hast. Für die Disponentin, über die im Transkript gesprochen wird, hast Du dadurch nicht automatisch eine Rechtsgrundlage. Ihre personenbezogenen Daten darfst Du deshalb nicht allein wegen eines AVV an den KI-Anbieter übermitteln.
Ein sauber bereinigtes Dokument braucht für den Upload dagegen weder einen AVV noch die Einwilligung der erwähnten Personen. Ist keine bestimmte Person mehr erkennbar, werden auch keine personenbezogenen Daten mehr verarbeitet.
Bevor Du auf Aufnahme drückst
Ein Transkript entsteht zunächst aus einer Aufzeichnung. Das ist der entscheidende erste Schritt, bei dem du danebengreifen kannst. Wer ein vertraulich gesprochenes Wort heimlich mitschneidet, macht sich strafbar, das steht in § 201 des Strafgesetzbuchs. Deshalb muss das Einverständnis aller Beteiligten vor dem Betätigen des Aufnahmeknopfs vorliegen und nicht danach. Ein Satz am Anfang des Gesprächs genügt: Du sagst, dass Du mitschneidest und was danach mit der Aufnahme passiert, und wartest, bis alle zustimmen.
Diese Zustimmung ist entscheidend. Das Hessische Landesarbeitsgericht hat am 23. August 2017 (Az. 6 Sa 137/17) die fristlose Kündigung eines Arbeitnehmers für gerechtfertigt gehalten, der ein Personalgespräch heimlich mitgeschnitten hatte.
Bevor Du hochlädst, was in der Datei steckt
Liegt Dir die Abschrift vor, wirf zwei Blicke darauf, bevor sie ins Eingabefeld wandert.
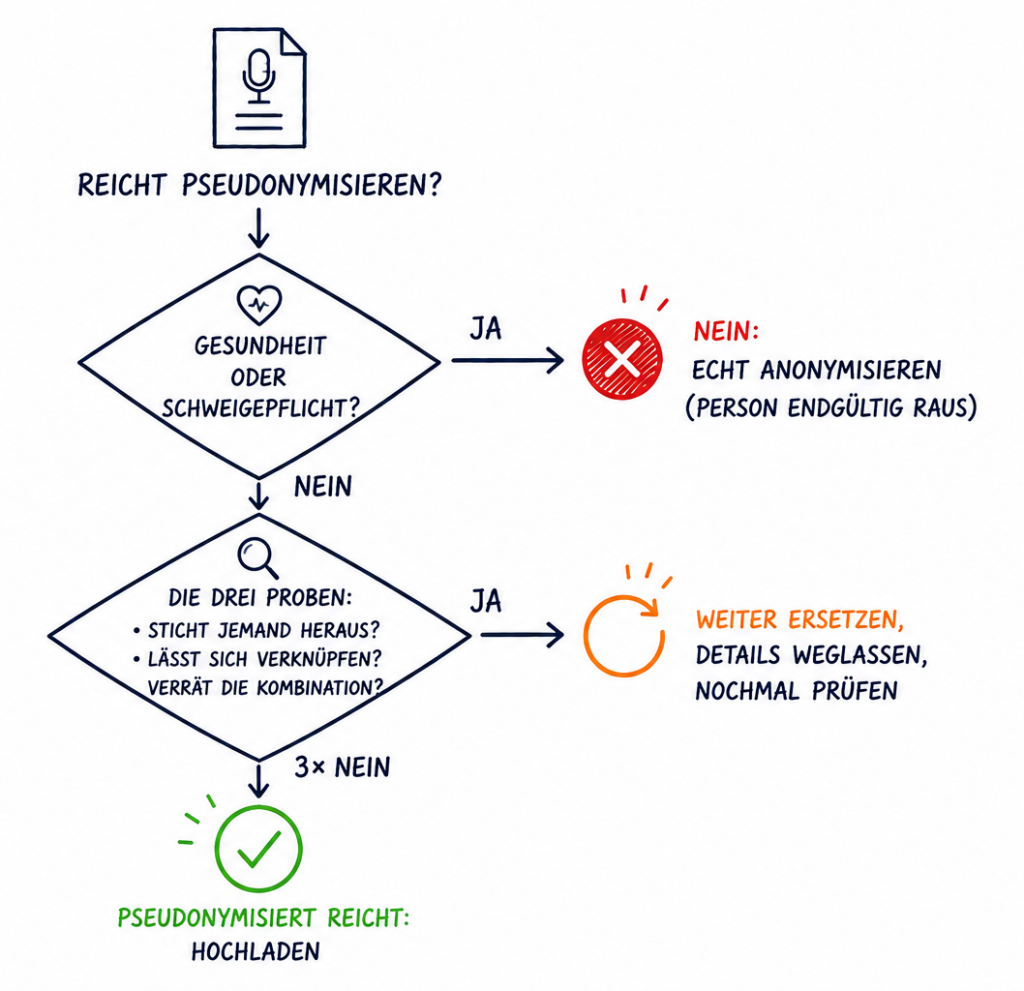
Der erste gilt der Datenart. Geht es um Gesundheit oder um etwas, das unter eine Schweigepflicht fällt, liegt die Latte höher als bei einem gewöhnlichen Vertriebsgespräch.
Der zweite Blick gilt den Menschen, über die im Gespräch geredet wird, ohne dass sie am Tisch saßen. In fast jedem aufgezeichneten Gespräch fällt irgendwann ein Satz über eine dritte Person, eine Mitarbeiterin, einen Lieferanten, einen Angehörigen. Von denen hast Du weder eine Einwilligung noch einen Vertrag.
Deshalb ist das Bereinigen vor dem Hochladen der saubere Weg. Welche Rolle und welche Datenart in Deinem Fall zusammenkommen, sortiert Dir die Daten-Ampel auf mensch-ki.de.
Die drei Proben für echte Anonymität
Am 7. Juli 2026 hat der Europäische Datenschutzausschuss, das gemeinsame Gremium der europäischen Datenschutzbehörden, neue Leitlinien zur Anonymisierung angenommen (Guidelines 02/2026, noch im Entwurf, öffentliche Konsultation bis zum 30. Oktober 2026).
Der Kern lässt sich in Alltagssprache übersetzen und ist zugleich Dein Test vor dem Absenden. Daten gelten erst dann als anonym, wenn drei Dinge nicht mehr gehen:
- Niemand kann eine einzelne Person herausgreifen, weil sie sich nicht von den anderen unterscheiden lässt.
- Niemand kann sie mit anderen Daten verknüpfen und so einen Namen dranhängen.
- Und aus dem, was dasteht, lässt sich nichts Neues über die Person erschließen.
Laufen alle drei ins Leere, ist das Dokument anonym.
Nicht nur Namen anonymisieren
Wer ein Dokument vorbereitet, streicht zuerst das Offensichtliche: Namen, Adressen, Telefonnummern, E-Mail-Adressen, Geburtsdaten, Kundennummern. Das erledigt jede Suchen-und-Ersetzen-Funktion.
Die eigentliche Arbeit steckt woanders, in dem, was Fachleute Quasi-Identifikatoren nennen: einzelne Angaben, die für sich harmlos aussehen, in Kombination aber wieder auf genau eine Person zeigen. Ort, Beruf und ein auffälliges Detail zusammen reichen oft schon. „Eine Führungskraft“ ist anonym. „Der einzige männliche Abteilungsleiter im Rathaus einer 12.000-Einwohner-Gemeinde, letztes Jahr aus Hamburg zugezogen“ ist es nicht, auch ohne Namen nicht.
Beim Ersetzen hilft eine Faustregel: Muster statt Wortlaut, Fall statt Person. Die KI braucht für einen guten Entwurf nicht die Biografie, sie braucht die Struktur des Problems. Ersetze die konkreten Merkmale durch die Kategorie, die für die Aufgabe zählt, und lass die schmückenden Einzelheiten weg. Sie bringen niemanden weiter außer den, der die Person sucht.
PDF anonymisieren: Richtig schwärzen statt übermalen
Ein schwarzer Balken macht einen Text nicht automatisch unlesbar. Oft liegt er nur als Grafik über den eigentlichen Zeichen.
Im Januar 2019 reichten die Anwälte von Paul Manafort, dem früheren Wahlkampfchef von Donald Trump, Gerichtsdokumente mit fehlerhaft geschwärzten Passagen ein. Journalisten markierten die Passagen schlicht und kopierten sie heraus, schon stand der Wortlaut unter den Balken. Zum echten Schwärzen gehört, die Zeichen darunter zu löschen, nicht ihnen bloß die Sicht zu nehmen.
Unsichtbar für den oberflächlichen Blick bleiben auch oft Metadaten in Dokumenten, die Dateieigenschaften, die kein Text zeigt. Autorname, Bearbeiter, Kommentare und frühere Versionen hängen in Word- und PDF-Dateien, ohne im Text aufzutauchen; bei einer abgetippten Aufnahme steht als Autor oft der Name des Büroservices, der das Gespräch übertragen hat. In Word förderst Du das über „Datei“, „Informationen“, „auf Probleme prüfen“ und „Dokument prüfen“ zutage und räumst es mit derselben Funktion weg.
Ein Transkript anonymisieren heißt: einmal ganz lesen
Suchen und Ersetzen kennt den vollen Namen, den Du eingibst, aber nicht den Rufnamen, der mitten im Redefluss fällt. Ein „sag der Bianca noch Bescheid“ zwei Seiten weiter rutscht durch, weil in der Suche „Bianca“ nie stand. In gesprochenen Abschriften passiert das leicht, deshalb hilft nur, den Text einmal ganz zu lesen statt ihn zu überfliegen.
Ein Transkript hält fest, was gesagt wurde, nicht nur das, woran Du Dich später erinnerst. Deshalb lohnt es sich, die Abschrift einmal vollständig zu lesen, bevor Du sie weiterverarbeitest.
Dazu kommt, dass in automatischen Abschriften auch Sätze stehen können, die nie gefallen sind.Eine Recherche der Nachrichtenagentur AP dokumentierte im Oktober 2024, dass das verbreitete Transkriptionswerkzeug Whisper in Sprechpausen ganze Sätze erfindet, darunter nie erwähnte Medikamente.Transkripte lassen nichts aus und dichten trotzdem dazu, also lies die Abschrift, bevor Du ihr traust.
Warum ein Gericht pseudonymisierte Daten für fast anonym hielt
Für den Alltag ist das die gute Nachricht: Meistens musst Du gar nicht bis zur echten Anonymität. Das stützt ein Urteil des Europäischen Gerichtshofs vom 4. September 2025. Gestritten hatten der Europäische Datenschutzbeauftragte und eine EU-Abwicklungsbehörde darüber, ob pseudonymisierte Kommentare von Aktionären der spanischen Banco Popular, die an die Beratungsfirma Deloitte weitergegeben worden waren, noch personenbezogen seien. Das Gericht entschied, das komme auf den Empfänger an. Für jemanden ohne realistische Möglichkeit, die Zuordnung wiederherzustellen, könnten pseudonymisierte Daten faktisch anonym sein. Für den, der den Schlüssel in der Hand hält, blieben sie personenbezogen. Das bedeutet nicht, dass pseudonymisierte Daten generell anonym sind. Entscheidend war im Urteil, ob der jeweilige Empfänger überhaupt eine realistische Möglichkeit hatte, die Person wieder zu identifizieren.
Übertragen auf Dein Eingabefeld heißt das, entscheidend ist, was der KI-Anbieter mit dem Dokument anfangen könnte. Steht im Text kein Weg zurück zur Person mehr, hat der Anbieter keinen Schlüssel, der bleibt bei Dir. Rechtsberatung ist das hier nicht, aber eine brauchbare Linie für den Werktag.
| Dokument | Reicht Pseudonymisieren? | Woran es hängt |
|---|---|---|
| Kundengespräch, Sitzungs-Transkript | Meistens ja | Namen und Merkmale werden Muster, der Fall bleibt auswertbar. Dritte im Gespräch mit ersetzen. |
| Vertrag, Angebot, Protokoll | Oft ja | Zahlen und Ablauf dürfen bleiben, Beteiligte werden Kategorien. |
| Bewerbungen, Personalunterlagen | Mit Vorsicht | Lebensläufe sind Ketten von Quasi-Identifikatoren; oft steckt Sensibles drin. |
| Gesundheit, Schweigepflicht (§ 203 StGB) | Nein | Höhere Latte: hier zählt echte Anonymität, Pseudonymisieren allein reicht nicht. |
Woran Du merkst, dass es reicht
Bevor Du auf Absenden gehst, leg die drei Proben an Dein Dokument an. Sticht noch ein Eintrag so heraus, dass jemand sagen könnte, das ist bestimmt die und die? Ließe sich das, was dasteht, mit einer Adressliste oder einer schnellen Suche verknüpfen? Und verrät die Kombination der Details etwas, das die Person eindeutig macht? Läuft alles dreimal ins Leere, kann auch die beste KI die Person nicht mehr herausrechnen.
Was nicht mehr drinsteht, kann nirgends auftauchen
Wie belastbar dieser Zustand ist, zeigte sich Ende 2025 in OpenAIs eigenem Prozess. Ein New Yorker Gericht bestätigte Anfang Dezember, dass die Firma 20 Millionen Chat-Protokolle an die New York Times und weitere klagende Verlage herausgeben muss. Zu sehen bekommen deren Anwälte aber nur bereinigte Fassungen: Vor der Herausgabe wurden die Protokolle von Namen und Kennungen befreit, und das Gericht stützte seine Entscheidung ausdrücklich auf diesen Schutz. Was in einem Text nicht mehr steht, gibt selbst eine Gerichtsanordnung nicht wieder her.
Damit Du das nicht bei jedem Dokument neu durchdenken musst, gibt es die 5-Minuten-Routine: dieselben Handgriffe in fester Reihenfolge, vom Suchen-und-Ersetzen bis zu den drei Proben, zum Abhaken neben dem Bildschirm. Und wer jede Woche Transkripte aufbereitet, kann sich die Handarbeit weitgehend abnehmen lassen: durch ein Werkzeug, das komplett auf dem eigenen Rechner läuft und heikle Stellen zum Gegenlesen markiert, bevor irgendetwas Deinen Computer verlässt. So etwas einzurichten ist ein typischer Beratungsfall bei mensch-ki.de.
Ob Dein Fall überhaupt bis zur echten Anonymisierung muss oder ob Pseudonymisieren reicht, hängt an Rolle und Datenart. Das musst Du nicht raten: Genau dafür habe ich die Daten-Ampel gebaut. Sie kennt den Zustand „pseudonymisiert“ als eigene Stufe und zeigt Dir für Deinen Fall, ob er damit auf Grün steht.
Die drei Proben stammen aus einem Entwurf, der noch bis Ende Oktober zur Diskussion steht. Wenn die Regeln stehen, setzen sie den Maßstab, an dem sich Anonymität misst. Die Frage, die Du Dir schon heute vor jedem Absenden stellen kannst, ist dieselbe, die der Ausschuss dann verbindlich macht: Bleibt in diesem Text noch irgendein Faden, an dem jemand die Person wieder herausziehen könnte?
Die drei Proben stammen aus dem Entwurf der EDPB-Leitlinien 02/2026. Auch wenn die Konsultation noch läuft, kannst Du sie schon heute als praktische Prüffragen nutzen.
Quellen: Europäischer Datenschutzausschuss (EDPB), Guidelines 02/2026 zur Anonymisierung, angenommen am 7. Juli 2026 (Entwurf, öffentliche Konsultation bis 30. Oktober 2026), erste Überarbeitung seit über einem Jahrzehnt, mit den drei Kriterien Herausgreifen, Verknüpfen, Erschließen; Europäischer Gerichtshof, Urteil vom 4. September 2025, Rechtssache C-413/23 P (Europäischer Datenschutzbeauftragter gegen Einheitlicher Abwicklungsausschuss / SRB), zur relativen Bewertung pseudonymisierter Daten je nach Empfänger; Verlauf des Verfahrens New York Times gegen OpenAI, gerichtlich bestätigte Herausgabe von 20 Millionen von Namen und Kennungen bereinigten Chat-Protokollen an die klagenden Verlage, Anfang Dezember 2025; Hessisches Landesarbeitsgericht, Urteil vom 23. August 2017, Az. 6 Sa 137/17, zur fristlosen Kündigung nach heimlichem Mitschnitt eines Personalgesprächs; fehlerhaft geschwärzte Gerichtsdokumente im Verfahren gegen Paul Manafort, Januar 2019; automatisch verschicktes Zoom-Transkript einer nicht öffentlichen Investoren-Nachbesprechung, September 2024 (Washington Post, 2. Oktober 2024); Recherche der Nachrichtenagentur AP zu erfundenen Passagen im Transkriptionswerkzeug Whisper, 26. Oktober 2024; rund 4.500 über die Teilen-Funktion öffentlich gewordene ChatGPT-Gespräche im Google-Index und die anschließende Abschaffung der Funktion durch OpenAI, Sommer 2025; § 201 Strafgesetzbuch (Verletzung der Vertraulichkeit des Wortes); Begriffe personenbezogene Daten, Anonymisierung und Pseudonymisierung nach Art. 4 DSGVO.
Wie anonymisiere ich ein Word-Dokument für ChatGPT?
Wie anonymisiere ich Kommentare in Word?
Wie anonymisiere ich eine PDF für ChatGPT?
Wie anonymisiere ich ein Transkript?
Was darf ich überhaupt bei ChatGPT hochladen?
Was passiert mit dem, was ich hochlade?
Kann ChatGPT das Anonymisieren nicht selbst übernehmen?
Muss ich auch Firmennamen und Orte entfernen?